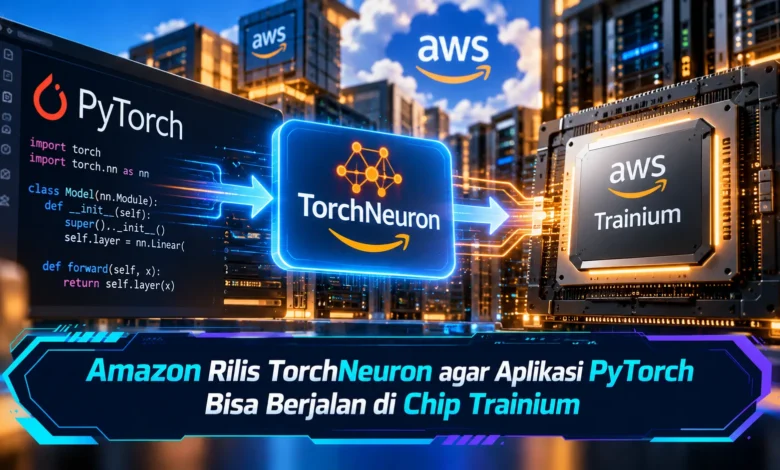
Amazon memperkenalkan TorchNeuron pada 19 Oktober 2026 sebagai langkah penting dalam memperluas penggunaan chip kecerdasan buatan AWS Trainium. Perangkat lunak ini memungkinkan pengembang menjalankan aplikasi dan model AI berbasis PyTorch pada chip Trainium tanpa harus menulis ulang sebagian besar kode yang sudah digunakan. TorchNeuron hadir dalam versi beta publik pada 20 Oktober 2026 dengan lisensi sumber terbuka Apache 2.0. Inovasi TEKNOLOGI ini menjadi perhatian karena berpotensi mengurangi ketergantungan pengembang terhadap satu platform perangkat keras. Selain membuka pilihan infrastruktur komputasi AI, Amazon juga ingin mempermudah perusahaan mengoptimalkan biaya dan meningkatkan fleksibilitas pengembangan kecerdasan buatan.
Apa Itu TorchNeuron dan Bagaimana Hubungannya dengan PyTorch?
TorchNeuron merupakan solusi kompatibilitas antara PyTorch dan akselerator AI AWS yang bertujuan menyederhanakan proses pemindahan beban kerja AI. Melalui teknologi tersebut, pengembang memiliki kesempatan menggunakan model AI yang telah dikembangkan pada chip kecerdasan buatan yang dikembangkan AWS dengan kebutuhan modifikasi aplikasi yang lebih terbatas. Tidak seperti pendekatan migrasi yang mengharuskan penyesuaian berbagai bagian kode, TorchNeuron memanfaatkan mekanisme ekstensi resmi PyTorch agar aplikasi mampu mengakses akselerator secara lebih langsung. Kemampuan tersebut membuka pilihan pengembangan baru bagi perusahaan teknologi.
Perusahaan AWS memperkenalkan TorchNeuron menjelang PyTorch Conference North America yang digunakan untuk memperkenalkan teknologi ini kepada komunitas pengembang. Inovasi terbaru ini tersedia dalam versi beta publik pada 20 Oktober 2026 dengan lisensi Apache 2.0. Pilihan distribusi sumber terbuka ini memberikan ruang untuk kontribusi komunitas sesuai aturan distribusi Apache 2.0. Backend baru tersebut mendukung generasi chip Trainium2 dan Trainium3. Berkat kompatibilitas tersebut, Amazon membuka kesempatan bagi pengembang untuk mencoba alternatif akselerator tanpa membangun ulang alur kerja dari awal.
Mekanisme Integrasi TorchNeuron untuk Komputasi Kecerdasan Buatan
Mekanisme utama perangkat lunak ini menggunakan kemampuan perluasan perangkat PyTorch yang dikenal sebagai PrivateUse1. Komponen perangkat lunak tersebut memberikan kemampuan untuk pengenalan jenis perangkat komputasi baru tanpa mengganti struktur dasar aplikasi. Dengan backend baru ini, chip Trainium terdaftar melalui penamaan device neuron. Pengembang kemudian, memiliki kemampuan memilih Trainium sebagai target komputasi melalui pengaturan perangkat dalam aplikasi. Pendekatan tersebut mendukung penggunaan API PyTorch yang sudah dikenal ketika menjalankan proses pelatihan.
Untuk melengkapi kemampuan backend, TorchNeuron menghadirkan pilihan cara menjalankan model, yaitu eager execution dan torch.compile. Dalam eksekusi eager, operasi PyTorch berlangsung mengikuti alur kode program sehingga peneliti dapat mengevaluasi operasi model secara langsung. Untuk kebutuhan performa produksi, torch.compile menyusun komputasi agar lebih sesuai dengan akselerator. TorchNeuron juga memungkinkan penggunaan Neuron Kernel Interface atau NKI. Fasilitas tersebut memungkinkan optimasi khusus terhadap kernel yang berjalan pada akselerator. Berkat fleksibilitas ini, pengguna dapat menyesuaikan strategi pengembangan berdasarkan karakteristik model AI.
Dukungan TorchNeuron untuk Model AI dan Ekosistem Hugging Face
Keunggulan teknis berikutnya dari TorchNeuron adalah kompatibilitas dengan komponen populer dalam pembelajaran mesin. Berbagai pustaka dari Hugging Face menjadi bagian dari dukungan tersebut. Dengan dukungan backend native, pustaka Transformers dan Diffusers mendukung pengembangan model pada backend tersebut. Pustaka Transformers mendukung beragam arsitektur pemrosesan bahasa, sedangkan Diffusers berkaitan dengan model difusi. Selain itu, TorchNeuron memanfaatkan mekanisme pembagian komputasi seperti Fully Sharded Data Parallelism dan tensor parallelism. Dukungan ini membantu menangani model yang lebih besar pada lingkungan komputasi dengan banyak chip.
Meski cakupan dukungannya semakin luas, TorchNeuron belum dapat dianggap mendukung seluruh model PyTorch. Pada tahap rilis awal, sejumlah fitur PyTorch masih membutuhkan pengembangan lanjutan. Di antara keterbatasan yang disebutkan meliputi operasi tensor sparse, NestedTensor, serta pemrosesan bentuk tensor dinamis. Selain itu, operasi yang tidak tersedia secara langsung pada backend dapat membutuhkan penanganan alternatif. Untuk menghindari kesalahan implementasi, pengguna perlu menguji operasi yang digunakan sebelum memindahkan pekerjaan produksi. Langkah ini membantu mengurangi risiko gangguan secara lebih terukur.
Manfaat TorchNeuron bagi Pengembang dan Perusahaan AI
Keuntungan penting dari kehadiran TorchNeuron adalah berkurangnya hambatan perpindahan perangkat keras. Sebelumnya, aplikasi yang dibangun untuk akselerator tertentu mungkin harus melalui proses validasi tambahan ketika dipindahkan ke platform berbeda. Berkat integrasi perangkat yang lebih langsung, pengembang memiliki kesempatan menguji Trainium dengan perubahan terbatas. Pendekatan pengembangan ini berpotensi menghemat waktu eksperimen. Meski menawarkan kemudahan, penggunaan pada sistem produksi harus melewati evaluasi stabilitas. Dengan proses tersebut, perusahaan dapat membuat keputusan berbasis kebutuhan.
Dari sisi biaya, AWS Trainium menjadi salah satu pilihan infrastruktur pelatihan dan inferensi. Penggunaan TorchNeuron mendukung pengujian alternatif komputasi antara Trainium dan akselerator dari penyedia berbeda. Manfaat ekonomi yang berpotensi muncul perlu dihitung berdasarkan penggunaan nyata. Aspek perhitungan penting mencakup harga penggunaan instans, kecepatan pelatihan model, pemanfaatan akselerator, serta biaya perpindahan sistem. Dalam skenario bisnis, harga komputasi yang lebih rendah belum tentu menjadi pilihan paling ekonomis apabila dibutuhkan optimasi tambahan yang mahal. Dengan pertimbangan tersebut, pengujian berdasarkan beban kerja sesungguhnya tetap diperlukan.
Persiapan Menjalankan Model PyTorch dengan TorchNeuron
Untuk memulai eksperimen dengan TorchNeuron perlu menyiapkan lingkungan AWS dengan dukungan Trainium2 atau Trainium3. Selain perangkat keras, pengguna perlu memperhatikan versi PyTorch dengan rilis AWS Neuron yang sedang digunakan. TorchNeuron tersedia melalui paket torch-neuronx dari repositori paket AWS Neuron. Proses instalasi sebaiknya menggunakan panduan kompatibilitas resmi karena kombinasi paket menentukan keberhasilan instalasi. Ketika semua dependensi tersedia, pengembang dapat mulai memindahkan model ke perangkat neuron dan memeriksa hasilnya secara bertahap.
Setelah model berhasil dijalankan perlu memeriksa konsistensi keluaran sebelum meningkatkan ukuran pekerjaan. Pengembang dapat memeriksa perubahan akurasi antara akselerator lama dan Trainium. Selain pengujian hasil, TorchNeuron mendukung analisis performa melalui torch.profiler bersama Neuron Explorer. Melalui kemampuan tersebut, pengembang dapat menelusuri operasi yang membutuhkan waktu besar. Data pemantauan tersebut membantu menentukan prioritas optimasi. Ketika pengembangan memasuki tahap produksi, evaluasi kebutuhan kapasitas, optimasi pemrosesan antarperangkat, dan evaluasi konsumsi sumber daya perlu mendapat perhatian khusus.
Kesimpulan tentang TorchNeuron dan Masa Depan Chip AI Amazon
Diperkenalkannya backend TorchNeuron memperlihatkan langkah baru dalam integrasi perangkat lunak dengan akselerator AI. Berkat pengembangan backend native PyTorch untuk Trainium2 dan Trainium3, Amazon berupaya mengurangi hambatan migrasi ketika mengembangkan aplikasi kecerdasan buatan. Kemampuan menjalankan mode eager, torch.compile, serta integrasi bersama alat pengembangan terbuka memperluas peluang penerapan. Kendati memiliki potensi besar, perhitungan biaya nyata tetap menjadi pertimbangan penting bagi perusahaan. Di tengah persaingan infrastruktur kecerdasan buatan, TorchNeuron berpotensi memperluas pilihan pengembang. Dari sudut pandang Anda, apakah integrasi perangkat lunak AI lintas perangkat keras akan membantu perusahaan mengurangi biaya AI? Ceritakan pemikiran Anda mengenai perkembangan chip AI Amazon.