Amazon Luncurkan TorchNeuron agar Kode PyTorch Lebih Mudah Berjalan di Chip Trainium

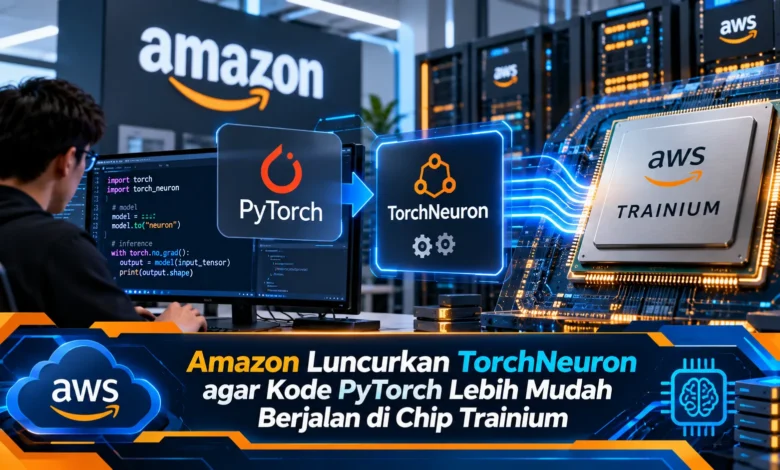
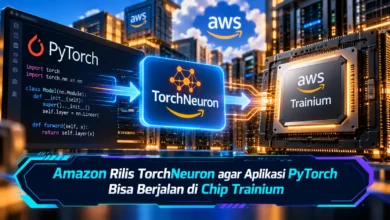
Amazon Web Services (AWS) resmi meluncurkan TorchNeuron dalam versi public beta pada 20 Oktober 2026 sebagai langkah penting untuk menyederhanakan pengembangan kecerdasan buatan. Teknologi open source ini memungkinkan pengembang menjalankan kode PyTorch secara lebih langsung pada chip AWS Trainium tanpa perlu melakukan penulisan ulang aplikasi secara menyeluruh. Kehadiran TorchNeuron memberikan pilihan baru bagi peneliti, perusahaan teknologi, dan pengembang model AI yang membutuhkan infrastruktur komputasi berkinerja tinggi. Melalui integrasi dengan PyTorch, Amazon berupaya mengurangi hambatan penggunaan akselerator AI sekaligus memperluas fleksibilitas pengembangan model machine learning di lingkungan cloud.
Apa Itu TorchNeuron dan Mengapa Penting bagi Pengguna PyTorch?
Melalui pengembangan terbarunya, Amazon meluncurkan TorchNeuron sebagai sistem integrasi PyTorch dengan perangkat keras khusus yang dirancang untuk mendukung penggunaan kode PyTorch pada chip Trainium. Dalam pendekatan komputasi yang lebih lama, penggunaan kode kecerdasan buatan pada arsitektur chip lain sering membutuhkan perubahan kode tertentu. Kondisi tersebut sering menambah pekerjaan tim teknis. Melalui peluncuran framework tersebut, tim rekayasa memiliki pilihan menjalankan model pembelajaran mesin yang telah dikembangkan melalui mekanisme kompatibilitas PyTorch native. Kemampuan ini menjadi perkembangan penting bagi komunitas machine learning.
Perangkat lunak tersebut diluncurkan melalui versi pengujian publik berbasis open source. Dalam ketersediaan saat ini, dukungan perangkat keras mencakup Amazon EC2 Trainium2 dan Trainium3. Kedua generasi akselerator tersebut ditujukan bagi beban kerja kecerdasan buatan yang mengandalkan akselerasi komputasi khusus. AWS turut mengintegrasikan TorchNeuron sebagai komponen dalam lingkungan pengembangan AWS Neuron. Hubungan antarkomponen ini memberikan fondasi untuk penggunaan akselerator Trainium melalui API PyTorch. Walaupun membawa pembaruan penting, setiap proyek tetap membutuhkan validasi teknis sebelum menjalankannya pada lingkungan berskala besar.
Mekanisme TorchNeuron untuk Mempermudah Penggunaan Akselerator AI
Dari sisi arsitektur, TorchNeuron memanfaatkan sistem ekstensi perangkat PyTorch yang dikenal sebagai PrivateUse1. Arsitektur ini menjadikan perangkat Trainium dapat diakses melalui antarmuka PyTorch tanpa mengharuskan pengembang meninggalkan ekosistem PyTorch. Sebagai contoh, kode yang sebelumnya menempatkan tensor pada CUDA dapat mengubah penempatan perangkat menjadi neuron. Penyesuaian sederhana ini dapat dilakukan dengan menggunakan .to(‘neuron’) sebagai pengaturan perangkat. Berkat dukungan backend native, banyak struktur kode PyTorch dapat digunakan kembali. Walaupun begitu, pengujian tetap diperlukan untuk memastikan fungsi aplikasi berjalan benar.
TorchNeuron menyediakan dukungan eager execution yang memungkinkan operasi PyTorch dijalankan saat dipanggil. Mode ini mempermudah eksperimen awal karena tim teknis lebih mudah menelusuri jalannya program. Sebagai kemampuan tambahan, TorchNeuron mendukung penggunaan torch.compile untuk mengoptimalkan eksekusi model. Melalui mekanisme kompilasi, sejumlah operasi dapat dianalisis bersama sebelum dijalankan pada akselerator. Pilihan metode eksekusi tersebut memungkinkan pemilihan pendekatan sesuai kebutuhan. Tim teknis berkesempatan menentukan mode yang sesuai dengan karakteristik proyek.
Cara TorchNeuron Mendukung Pengoptimalan Komputasi Trainium
Di samping mempermudah penggunaan framework, TorchNeuron turut mendukung Neuron Kernel Interface atau NKI. Komponen pengembangan tersebut memungkinkan pembuatan kernel khusus pada arsitektur perangkat keras Trainium. Pada implementasi AI berkinerja tinggi, penggunaan kernel umum belum tentu menghasilkan efisiensi terbaik. Dengan memanfaatkan Neuron Kernel Interface, tim optimasi dapat mengembangkan kernel komputasi dengan karakteristik khusus. Dalam skenario optimasi, operasi tensor tertentu dapat dioptimalkan berdasarkan karakteristik chip. Walaupun memiliki potensi tersebut, hasil optimasi memerlukan benchmark yang objektif.
Untuk membantu proses evaluasi, AWS menyediakan Neuron Explorer yang mendukung pemeriksaan profil eksekusi. Berkat dukungan alat profiling PyTorch, peneliti berkesempatan menganalisis perilaku model hingga keterkaitan operasi terhadap baris program. Kemampuan ini mempermudah identifikasi bottleneck. Misalnya, apabila proses pelatihan berjalan lebih lambat dari harapan, pengembang dapat meninjau profil aktivitas. Temuan dari proses profiling kemudian menjadi dasar pengoptimalan kode. Berkat kombinasi alat pengembangan, TorchNeuron tidak hanya mempermudah kompatibilitas.
Keunggulan Integrasi PyTorch dengan AWS Trainium
Nilai utama dari kehadiran TorchNeuron adalah pengurangan pekerjaan migrasi perangkat lunak. Dalam pengembangan kecerdasan buatan, pengembang sering memerlukan sumber daya tambahan untuk memeriksa hasil komputasi. Apabila perubahan perangkat keras membutuhkan penulisan ulang besar, beban pekerjaan teknis bisa bertambah. TorchNeuron berupaya mengatasi kompleksitas migrasi tersebut dengan mendukung penggunaan kode yang sudah tersedia. Dengan kemampuan ini, peneliti memperoleh fleksibilitas dalam memilih hardware. Namun, manfaat nyata perlu dievaluasi berdasarkan model dan kebutuhan komputasi.
Dalam lingkungan bisnis berbasis kecerdasan buatan, TorchNeuron membuka alternatif penggunaan akselerator melalui AWS Trainium. Pilihan tersebut dapat membantu perusahaan membandingkan performa komputasi berbagai beban kerja. Dalam skenario penggunaan nyata, biaya komputasi menjadi faktor penting. Perusahaan perlu mempertimbangkan harga penggunaan instance, durasi pelatihan, serta biaya pengelolaan sistem. Melalui kompatibilitas framework yang meningkat, pengujian alternatif infrastruktur berpotensi semakin sederhana. Walaupun Amazon menekankan efisiensi Trainium, biaya operasional perlu dibandingkan menggunakan data penggunaan nyata.
Peluang Pemanfaatan TorchNeuron dalam Pengembangan Model AI Modern
Peluncuran integrasi Trainium terbaru menyediakan fondasi bagi beragam pekerjaan machine learning. Sektor yang membutuhkan dukungan komputasi adalah pelatihan model bahasa berskala besar. Model seperti ini mengandalkan komputasi paralel berkapasitas tinggi. TorchNeuron mendukung API PyTorch untuk komputasi terdistribusi seperti DistributedDataParallel, FullyShardedDataParallel, dan DTensor. Berkat integrasi tersebut, pengembang dapat memanfaatkan pendekatan pelatihan paralel pada lingkungan Trainium yang sesuai. Walaupun menyediakan dukungan teknis, konfigurasi distribusi tetap membutuhkan pengujian.
Selain model bahasa, TorchNeuron berpotensi digunakan dalam penelitian sistem pembelajaran mesin untuk data multimedia. Perusahaan teknologi yang mengembangkan model melalui library AI populer memiliki kesempatan memanfaatkan akselerator AWS melalui integrasi PyTorch native. Kemampuan integrasi tersebut memiliki relevansi pada beragam bidang seperti penelitian model dunia, analisis visual, serta eksperimen ilmiah berbasis AI. Walaupun potensi penerapannya luas, tingkat kompatibilitas tidak selalu identik pada semua aplikasi. Oleh sebab itu, pengembang tetap perlu menguji akurasi hasil sebelum memindahkan layanan ke produksi.
Penutup: Dampak TorchNeuron bagi Masa Depan Komputasi AI
Pengembangan TorchNeuron dalam ekosistem Trainium menjadi langkah penting dalam memperluas pilihan akselerator AI. Berkat mekanisme backend standar, peneliti memperoleh cara lebih sederhana untuk menjalankan model pada Trainium. Kemampuan eksekusi langsung, torch.compile, serta Neuron Kernel Interface membantu eksperimen sekaligus peningkatan performa. Kendati pengembangannya terus berlanjut, TorchNeuron memiliki potensi untuk mempermudah penggunaan akselerator AI. Dalam transformasi TEKNOLOGI komputasi modern, kompatibilitas software dan hardware semakin menentukan efisiensi. Dari sudut pandang Anda, seberapa besar pengaruh integrasi PyTorch terhadap pilihan chip AI? Bagikan pemikiran Anda mengenai masa depan infrastruktur AI.