Local LLM Runtime Makin Populer di 2026, AI Kini Bisa Berjalan Cepat Tanpa Bergantung pada Cloud

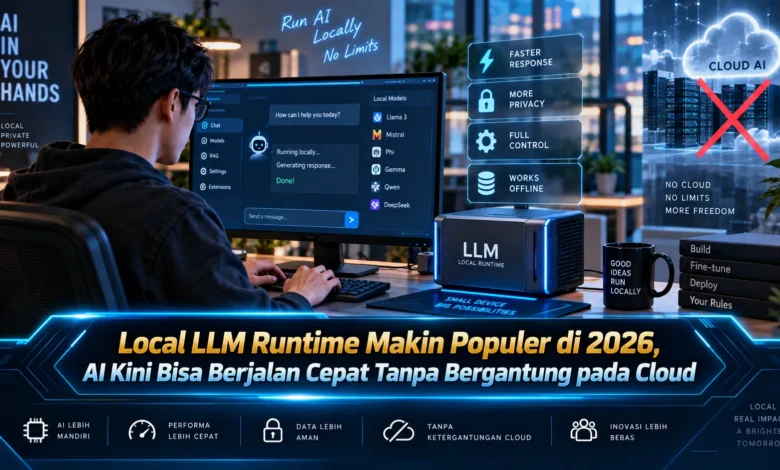
Perkembangan kecerdasan buatan pada 2026 semakin menarik dengan meningkatnya penggunaan Local LLM Runtime, yaitu pendekatan yang memungkinkan model bahasa dijalankan langsung pada komputer, laptop, workstation, atau perangkat lokal tanpa harus selalu mengirim proses ke server cloud. Kemajuan perangkat keras dan optimasi model membuat TEKNOLOGI AI lokal semakin praktis untuk berbagai kebutuhan, mulai dari menulis, merangkum dokumen, membantu pemrograman, hingga mengolah informasi pribadi dengan kontrol data yang lebih besar.
AI Lokal Semakin Populer Berkat Perkembangan Local LLM Runtime
Penggunaan Local LLM Runtime semakin meluas karena banyak pengguna membutuhkan kecerdasan buatan yang dapat diproses secara lokal tanpa ketergantungan penuh terhadap infrastruktur cloud. Melalui pemrosesan di perangkat, permintaan pengguna dapat ditangani langsung oleh sistem lokal tanpa perlu selalu dikirim ke pusat data berbasis internet. Kemajuan ini menjadikan TEKNOLOGI AI lebih mudah disesuaikan karena pengguna dapat menentukan apakah model dijalankan melalui perangkat sendiri atau menggunakan layanan daring.
Pertumbuhan penggunaan AI lokal turut dipengaruhi oleh hadirnya model yang semakin efisien sehingga dapat dijalankan pada perangkat dengan kemampuan komputasi yang lebih beragam. Teknik optimasi seperti quantization membantu mengurangi kebutuhan memori sehingga model berukuran besar dapat dipadatkan menjadi format yang lebih sesuai untuk penggunaan lokal. Perkembangan tersebut membuat AI lokal mulai berpindah dari lingkungan eksperimen menuju penggunaan praktis dalam aktivitas sehari hari.
Mengapa Local LLM Bisa Berjalan Lebih Cepat Tanpa Cloud
Salah satu daya tarik Local LLM Runtime adalah kemampuan memberikan respons tanpa harus menunggu perjalanan data dari perangkat menuju server cloud lalu kembali lagi kepada pengguna. Jika komputer memiliki CPU, GPU, NPU, serta kapasitas memori yang sesuai, model dapat memproses banyak tugas dengan waktu respons yang relatif cepat. Kecepatan akhirnya bergantung pada ukuran model, panjang konteks, metode quantization, optimasi runtime, dan kemampuan perangkat yang digunakan.
Pemrosesan di perangkat memungkinkan beberapa fungsi AI tetap digunakan ketika jaringan internet mengalami gangguan maupun keterbatasan. Pengguna dapat memproses dokumen, kode, atau informasi lainnya secara lokal selama model dan runtime telah tersimpan di perangkat meskipun akses internet sedang terbatas. Karakteristik tersebut membuat TEKNOLOGI Local LLM menarik bagi pengguna yang mengutamakan fleksibilitas sekaligus ketersediaan sistem AI kapan saja.
Privasi Data Menjadi Alasan Banyak Pengguna Memilih AI Lokal
Tidak hanya menawarkan kecepatan, Local LLM Runtime juga menarik dari sisi privasi sebab informasi dapat tetap diproses di dalam perangkat lokal. Dokumen internal, catatan pribadi, kode program, atau informasi lainnya dapat diproses secara lokal apabila sistem dikonfigurasi tanpa mengirimkan data kepada layanan eksternal. Pemrosesan di perangkat memungkinkan pengguna memiliki kontrol lebih jelas terhadap tempat data berada serta aplikasi yang diperbolehkan membacanya.
Walaupun proses dilakukan secara lokal, keamanan tidak otomatis terjamin karena masih bergantung pada pengaturan sistem, perangkat lunak, jaringan, serta cara pengguna mengelolanya. Perangkat yang terinfeksi malware atau memiliki akses pengguna yang tidak terlindungi tetap dapat membahayakan informasi yang tersimpan secara lokal. Karena itu perkembangan TEKNOLOGI AI lokal tetap perlu disertai kebiasaan keamanan seperti pembaruan sistem, enkripsi, perlindungan akun, dan pengelolaan izin aplikasi.
Kemajuan Hardware Mempercepat Pertumbuhan Local LLM
Perkembangan perangkat keras menjadi salah satu faktor utama yang membuat Local LLM Runtime semakin praktis karena komputer modern memiliki kemampuan pemrosesan AI yang terus meningkat. GPU mampu mempercepat perhitungan model sedangkan NPU memberikan jalur khusus untuk mengolah sebagian tugas AI secara lebih efisien. Kapasitas RAM dan memori grafis juga memiliki peran penting karena model serta konteks membutuhkan ruang penyimpanan sementara selama proses inferensi berlangsung.
Tidak semua pengguna harus memakai komputer berharga tinggi sebab model ringan yang dioptimalkan dapat menangani banyak kebutuhan produktivitas. Menyesuaikan ukuran model dengan kemampuan hardware menjadi langkah penting supaya penggunaan AI lokal tetap cepat dan stabil. Fleksibilitas memilih model membuat TEKNOLOGI Local LLM dapat digunakan pada lebih banyak jenis perangkat tanpa selalu membutuhkan konfigurasi paling mahal.
Local LLM Cocok untuk Produktivitas Coding dan Pengolahan Dokumen
Penggunaan Local LLM dapat mencakup aktivitas seperti meringkas dokumen, menyusun teks, memahami catatan, mencari informasi pada file, dan membantu proses coding. Bagi pengembang, model lokal dapat diintegrasikan dengan perangkat lunak sehingga fitur AI dapat berjalan langsung di lingkungan pengguna. Pendekatan tersebut memungkinkan lahirnya aplikasi AI yang lebih mandiri serta memberikan kendali lebih luas terhadap informasi yang digunakan.
Di organisasi, Local LLM dapat mendukung pencarian data internal, penyusunan informasi, maupun otomatisasi pekerjaan selama penggunaan mengikuti kebijakan keamanan. Model dapat digabungkan dengan basis data maupun sistem pencarian lokal agar respons lebih relevan terhadap informasi yang tersedia di lingkungan tertentu. Kemampuan tersebut memperlihatkan potensi TEKNOLOGI Local LLM sebagai komponen kerja yang dapat dihubungkan dengan beragam aplikasi serta sistem informasi.
Cloud dan Local LLM Bisa Saling Melengkapi
Pertumbuhan Local LLM tidak otomatis menggantikan layanan cloud karena masing masing metode menawarkan manfaat sesuai kebutuhan pengguna. Cloud tetap menarik untuk menjalankan model yang sangat besar atau tugas yang membutuhkan sumber daya komputasi tinggi sementara pemrosesan lokal lebih cocok untuk kebutuhan yang mengutamakan respons cepat, privasi, dan ketersediaan offline. Pemilihan metode dapat dilakukan berdasarkan tingkat pekerjaan, kebutuhan privasi, kemampuan perangkat, serta sumber daya yang tersedia.
Kombinasi lokal dan cloud berpeluang berkembang dengan membagi pekerjaan berdasarkan kebutuhan sumber daya serta tingkat kompleksitas. Strategi hybrid memungkinkan pengguna memperoleh keseimbangan antara respons cepat, privasi lokal, serta kemampuan komputasi cloud. Arah tersebut menunjukkan bahwa masa depan TEKNOLOGI AI kemungkinan tidak hanya berpusat pada cloud tetapi juga pada distribusi pemrosesan yang semakin dekat dengan perangkat pengguna.
Kesimpulan Perkembangan Local LLM Runtime di 2026
Local LLM Runtime menunjukkan perubahan penting pada 2026 ketika AI semakin mudah diproses secara langsung melalui perangkat pengguna tanpa ketergantungan penuh terhadap layanan cloud. Manfaat berupa respons cepat, penggunaan offline, kendali terhadap data, dan pilihan model yang fleksibel membuat AI lokal semakin relevan untuk pengguna serta developer. Kemajuan hardware dan optimasi model juga membantu memperluas penggunaan AI lokal sehingga tidak selalu membutuhkan komputer dengan konfigurasi ekstrem. Dengan perkembangan yang terus berlanjut, TEKNOLOGI Local LLM berpotensi menjadi bagian penting dari ekosistem AI masa depan sekaligus memberi pengguna lebih banyak pilihan mengenai bagaimana dan di mana kecerdasan buatan dijalankan.